کاهش ۷۷ درصدی هزینه استنتاج با تخصصیسازی واژگان مدلهای زبانی کوچک
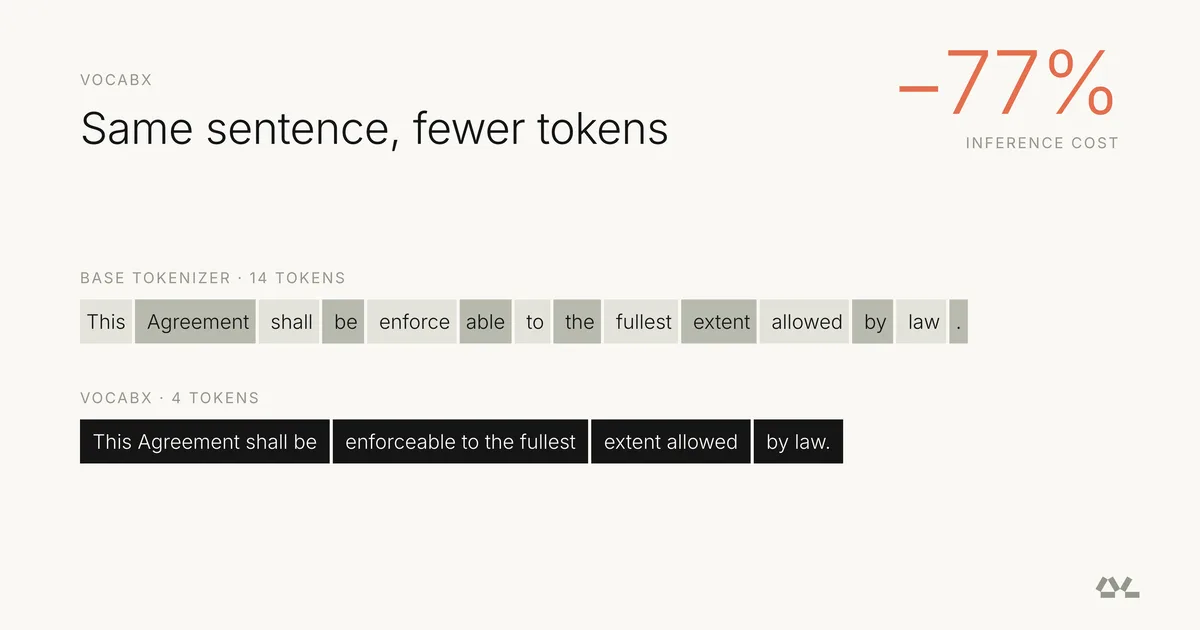
مقالهای در وبلاگ هاگینگ فیس نشان میدهد که تخصصیسازی واژگان مدلهای زبانی کوچک میتواند هزینه استنتاج را تا ۷۷ درصد کاهش دهد. این روش با محدود کردن واژگان به دامنه کاربرد، اندازه پارامترهای مرتبط با واژگان را کم میکند.
بر اساس مقالهای که در وبلاگ هاگینگ فیس منتشر شده است، تخصصیسازی واژگان مدلهای زبانی کوچک (Small Language Models) میتواند هزینه استنتاج (Inference Cost) را در کاربردهای واقعی تا ۷۷ درصد کاهش دهد. این روش بر کاهش اندازه واژگان (Vocabulary) و در نتیجه کوچکتر شدن ماتریس جاسازی (Embedding Matrix) و لایه خروجی (Output Layer) تمرکز دارد. در مدلهای زبانی متداول، واژگان بزرگ شامل دهها هزار توکن است که بخش قابلتوجهی از پارامترهای مدل را به خود اختصاص میدهد. هنگامی که مدل برای یک حوزه تخصصی مانند حقوق، پزشکی یا پشتیبانی مشتری به کار میرود، بسیاری از این توکنها عملاً استفاده نمیشوند. با جایگزینی واژگان عمومی با مجموعهای محدودتر و دامنهمحور، میتوان اندازه مدل را کاهش داد و در عین حال کیفیت خروجی را در آن حوزه حفظ کرد. مقاله مذکور گزارش میدهد که این رویکرد در آزمایشهای واقعی به کاهش ۷۷ درصدی هزینه استنتاج منجر شده است. کاهش هزینه عمدتاً از طریق کمتر شدن تعداد پارامترهای فعال در مرحله استنتاج و کاهش مصرف حافظه حاصل میشود. این موضوع برای استقرار مدلها روی سختافزارهای محدود یا در مقیاس بالا اهمیت دارد. برای توسعهدهندگان ایرانی، این روش میتواند به معنای امکان اجرای مدلهای زبانی کوچکتر و کمهزینهتر روی زیرساختهای داخلی باشد. با توجه به محدودیتهای دسترسی به توان پردازشی پیشرفته و هزینههای ارزی، تخصصیسازی واژگان میتواند راهکاری عملی برای کاهش وابستگی به سختافزار گرانقیمت و بهینهسازی مصرف منابع در پروژههای بومی باشد. البته میزان اثربخشی به دامنه کاربرد و کیفیت مجموعه داده تخصصی بستگی دارد. جزئیات کامل این پژوهش، شامل روششناسی و نتایج آزمایشها، در وبلاگ هاگینگ فیس قابل دسترسی است.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی