انویدیا از پیشآموزش ۲.۸ تریلیون توکنی Indic خبر داد
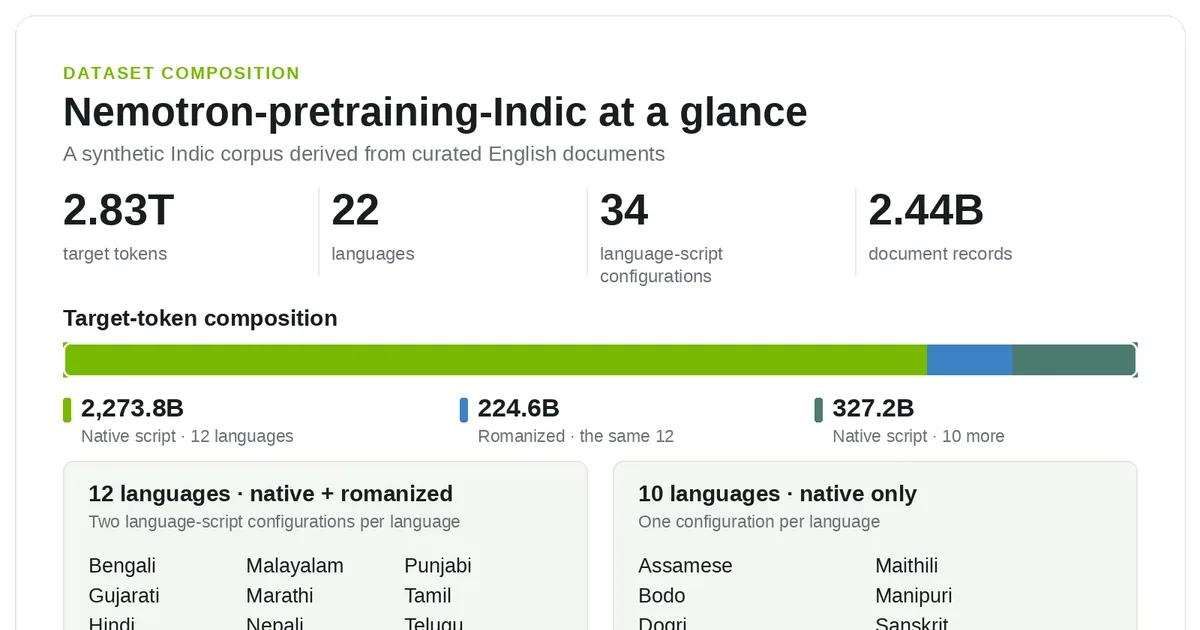
انویدیا یک مجموعهداده پیشآموزشی مصنوعی حدود ۲.۸۳ تریلیون توکنی را برای ۲۲ زبان هندی و ۳۴ پیکربندی زبان و خط توسعه داده است. این پروژه از یک خط لوله چندمرحلهای برای ترجمه، ارزیابی کیفیت و بازنویسی دادهها استفاده میکند و انتشار مجموعهداده و ابزارهای تولید آن را دنبال میکند.
انویدیا در پروژه مقیاسدهی پیشآموزش زبانهای هندی (Indic Pretraining) از مجموعهای شامل حدود ۲.۸۳ تریلیون توکن خبر داده است. این دادهها ۲۲ زبان هندی و ۳۴ پیکربندی زبان و خط را پوشش میدهند و عمدتاً از اسناد انگلیسی ترجمهشده تولید شدهاند. این مجموعه برای پیشآموزش و ادامهآموزش مدلهای زبانی چندزبانه طراحی شده است. برای ۱۲ زبان با اولویت بالاتر، خط لوله تولید داده از چند مرحله تشکیل شده است: ترجمه اسناد، امتیازدهی کیفیت ترجمه، بازنویسی نمونههای دارای امتیاز پایین و ارزیابی مجدد. برای ۱۰ زبان کممنبعتر نیز از ترجمه ماشینی و مدلهای زبانی برای کنترل کیفیت استفاده شده است. این فرایند با هدف افزایش کیفیت دادههای مصنوعی و استانداردسازی تولید داده در مقیاس بزرگ طراحی شده است. طبق مستندات فنی انویدیا، ادامهآموزش (Continued Pretraining) با دادههای Indic باعث بهبود عملکرد در پنج معیار ارزیابی زبانهای هندی شده است. برای نمونه، امتیاز MILU از ۷۲.۴۸ به ۷۷.۹۰ و امتیاز Indic GSM8K از ۷۲.۶۷ به ۸۲.۴۹ افزایش یافته است؛ همچنین در آزمونهای Indic MMLU-Pro، ARC-C و ARC-E نیز بهبود ثبت شده است. برای توسعهدهندگان ایرانی، این پروژه از آن جهت اهمیت دارد که نشان میدهد تولید دادههای چندزبانه و کممنبع در مقیاس تریلیون توکن میتواند با خط لولههای خودکار ترجمه و ارزیابی انجام شود. رویکرد مشابه میتواند برای ساخت مجموعهدادههای فارسی، ارزیابی کیفیت ترجمه و توسعه مدلهایی با عملکرد بهتر در زبانهای کممنبع مورد بررسی قرار گیرد. انویدیا اعلام کرده است که قصد دارد مجموعهداده Indic، خط لولههای تولید داده و با همکاری AI4Bharat یک مجموعه ارزیابی تأییدشده توسط انسان را منتشر کند. این انتشار میتواند دسترسی پژوهشگران و توسعهدهندگان به داده و فرایندهای قابل بررسی برای آموزش مدلهای چندزبانه را افزایش دهد.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی