ترمیم آگاه به کوانتیزهسازی: مدل ۴ بیتی با عملکرد بهتر از نسخه اصلی
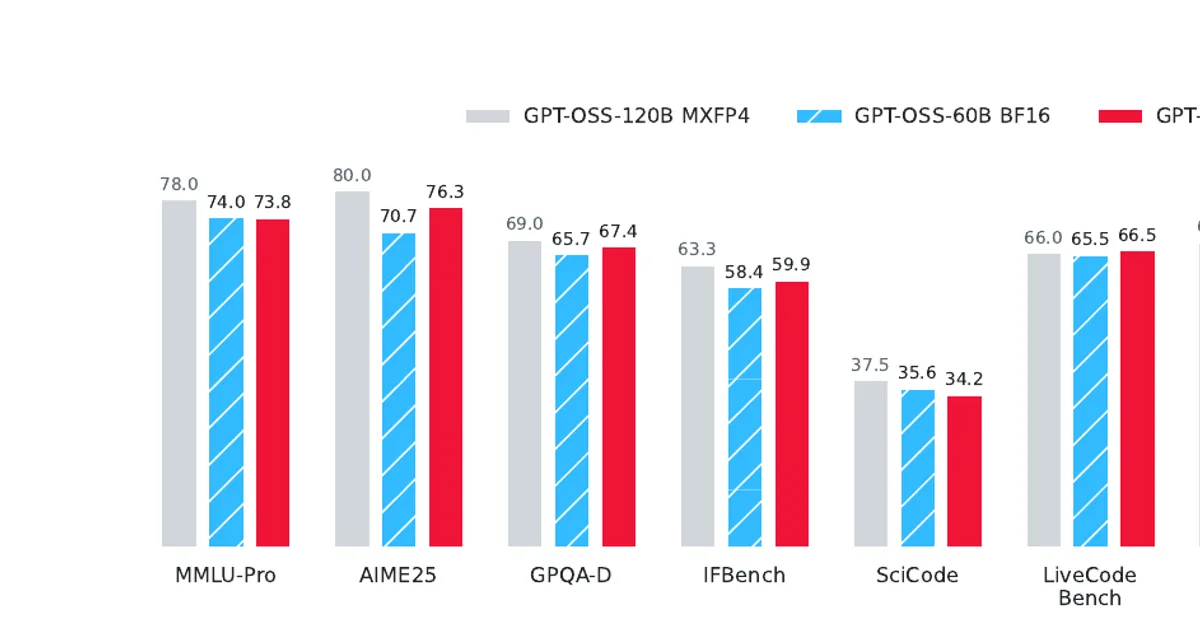
محققان روشی به نام ترمیم آگاه به کوانتیزهسازی را معرفی کردند که طی آن یک مدل ۴ بیتی پس از ترمیم، عملکردی بهتر از نسخه با دقت کامل ارائه میدهد. این روش نشان میدهد فشردهسازی مدلها میتواند بدون کاهش کیفیت و حتی با بهبود آن انجام شود.
شرکت MultiverseComputingCAI در وبلاگ Hugging Face روشی جدید به نام «ترمیم آگاه به کوانتیزهسازی» (Quantization-Aware Healing) را معرفی کرد. در این روش، یک مدل زبانی که به صورت ۴ بیتی کوانتیزه شده است، پس از طی فرآیند ترمیم، عملکردی بهتر از نسخه اصلی با دقت کامل از خود نشان میدهد. این یافته میتواند رویکرد رایج به فشردهسازی مدلها را به چالش بکشد. کوانتیزهسازی (Quantization) فرآیندی است که در آن وزنهای مدل با دقت پایینتر (مثلاً ۴ بیت به جای ۱۶ یا ۳۲ بیت) ذخیره میشوند تا حجم مدل و هزینه استنتاج کاهش یابد. معمولاً این کار با افت دقت همراه است. اما در روش جدید، پس از کوانتیزهسازی، مرحلهای برای ترمیم (Healing) انجام میشود که ظاهراً اثرات منفی فشردهسازی را جبران کرده و حتی عملکرد را بهبود میبخشد. جزئیات فنی این روش در پست وبلاگ منتشر شده است، اما به طور خلاصه، ترمیم آگاه به کوانتیزهسازی شامل تنظیم دقیق مدل کوانتیزهشده با استفاده از دادههای اضافی است تا مدل بتواند خود را با محدودیتهای دقت پایین سازگار کند. این فرآیند可能导致 مدل ۴ بیتی در برخی معیارها از نسخه اصلی پیشی بگیرد. برای توسعهدهندگان ایرانی، این خبر اهمیت ویژهای دارد. با توجه به محدودیت دسترسی به منابع محاسباتی پیشرفته و هزینه بالای استفاده از مدلهای بزرگ، روشهایی که بتوانند مدلهای فشردهتر با عملکرد بهتر ارائه دهند، میتوانند به کاهش هزینهها و افزایش دسترسیپذیری کمک کنند. توسعهدهندگان میتوانند این روش را در پروژههای خود آزمایش کنند و از مدلهای ۴ بیتی با کیفیت بالاتر بهره ببرند. این تحقیق نشان میدهد که کوانتیزهسازی لزوماً به معنای کاهش کیفیت نیست و با تکنیکهای مناسب میتوان به تعادل بهتری بین کارایی و دقت دست یافت. نتایج این مطالعه میتواند مسیر جدیدی برای بهینهسازی مدلهای زبانی باز کند.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی