پروفایلینگ TorchNeuron روی AWS Trainium
هاگینگ فیس نخستین بخش از مجموعه مقالات پروفایلینگ TorchNeuron را منتشر کرد که به بررسی پروفایلینگ در سطح سیستم روی AWS Trainium میپردازد. این مطلب بر شناسایی گلوگاههای عملکردی و بهینهسازی بارهای کاری یادگیری ماشین تمرکز دارد.
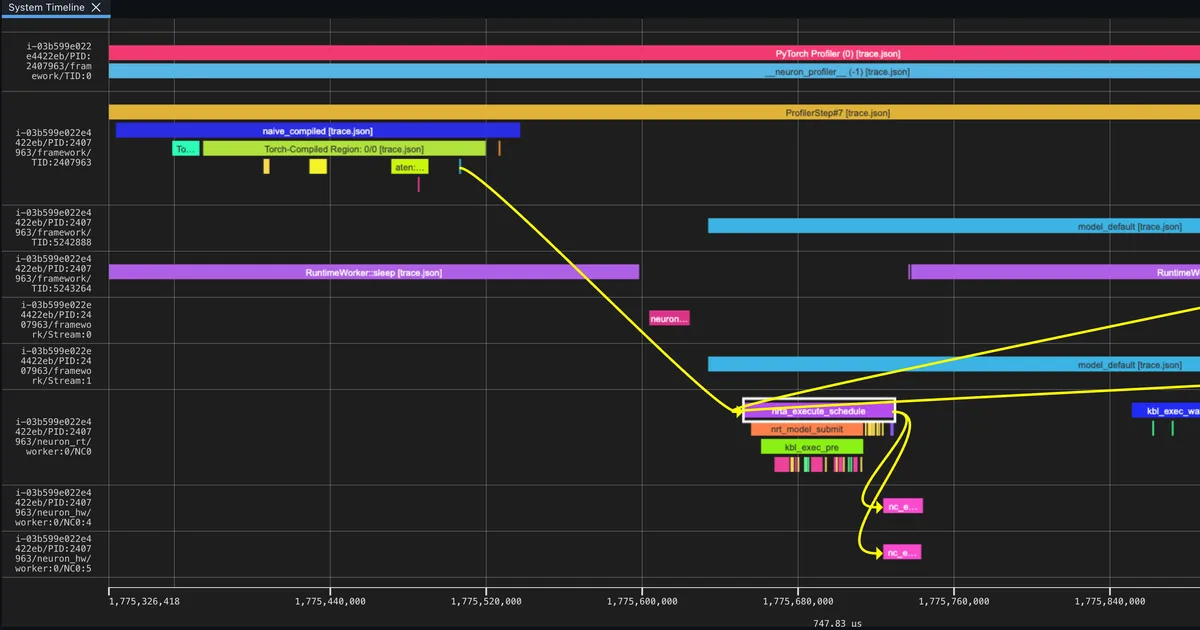
تیم هاگینگ فیس نخستین بخش از مجموعه مقالات فنی خود با عنوان «پروفایلینگ TorchNeuron» را منتشر کرد. این بخش به پروفایلینگ در سطح سیستم (System-level profiling) روی شتابدهنده AWS Trainium اختصاص دارد و هدف آن ارائه روشهایی برای تحلیل عملکرد مدلهای یادگیری ماشین روی این سختافزار است. در این مطلب، نویسندگان به ابزارها و تکنیکهای پروفایلینگ میپردازند که به توسعهدهندگان امکان میدهد گلوگاههای عملکردی (Performance bottlenecks) را در سطح سیستم شناسایی کنند. تمرکز اصلی بر نحوه تعامل کتابخانه TorchNeuron با معماری Trainium و چگونگی بهینهسازی بارهای کاری (Workloads) است. پروفایلینگ در سطح سیستم برای درک رفتار مدلهای بزرگ زبانی و بینایی روی شتابدهندههای تخصصی ضروری است. این مقاله بخشی از تلاش گستردهتر برای شفافسازی فرآیند بهینهسازی روی سختافزارهای غیر از GPUهای رایج بازار محسوب میشود. برای توسعهدهندگان ایرانی، این مطلب از آن جهت اهمیت دارد که امکان ارزیابی گزینههای سختافزاری جایگزین برای استقرار مدلهای هوش مصنوعی را فراهم میکند. با توجه به محدودیتهای دسترسی به GPUهای پیشرفته، آشنایی با پروفایلینگ روی Trainium میتواند به انتخاب زیرساخت مناسبتر و کاهش هزینههای عملیاتی کمک کند. انتشار این مجموعه مقالات نشاندهنده ادامه همکاری میان هاگینگ فیس و آمازون در حوزه بهینهسازی مدلهای باز است. بخشهای بعدی این مجموعه احتمالاً به جنبههای دقیقتر پروفایلینگ و تنظیم عملکرد خواهند پرداخت.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی