تحلیل عملکرد TorchNeuron روی پردازنده Trainium آمازون
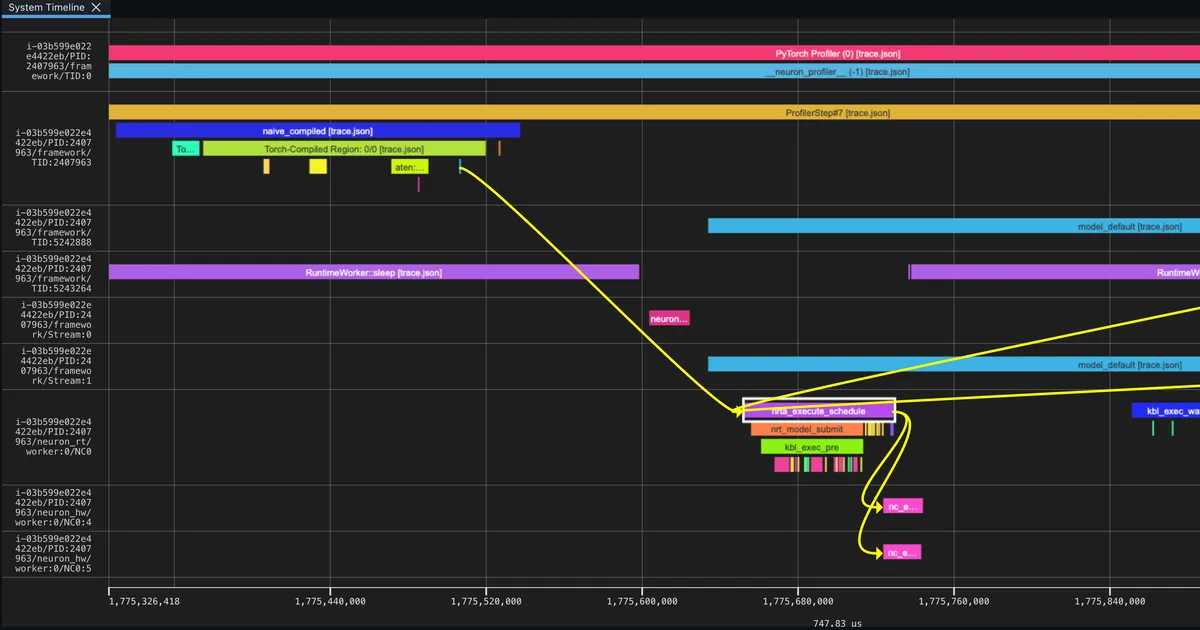
Hugging Face published a guide on system-level profiling of TorchNeuron on AWS Trainium. The article helps developers identify performance bottlenecks when training AI models on Trainium hardware.
هاشینگ فیس بخش اول راهنمای پروفایلینگ TorchNeuron را منتشر کرد که بر تحلیل عملکرد سطح سیستمی روی پردازنده AWS Trainium تمرکز دارد. TorchNeuron افزونهای برای PyTorch است که توسط آمازون توسعه یافته و امکان اجرای بهینه مدلهای هوش مصنوعی روی سختافزار Trainium را فراهم میکند. پروفایلینگ (Profiling) فرآیندی است که به توسعهدهندگان امکان میدهد زمان اجرای هر بخش از کد، مصرف حافظه و استفاده از منابع سختافزاری را بهدقت بررسی کنند. این مقاله ابزارها و روشهایی را معرفی میکند که برای شناسایی گلوگاههای عملکردی هنگام آموزش مدلهای بزرگ روی Trainium ضروری هستند. AWS Trainium یک پردازنده تخصصی برای آموزش مدلهای یادگیری ماشین است که آمازون برای رقابت با GPUهای انویدیا توسعه داده است. این سختافزار بهویژه برای آموزش مدلهای زبانی بزرگ (LLM) و مدلهای تبدیلی (Transformer) بهینهسازی شده است. برای توسعهدهندگان ایرانی که به دلیل تحریمها دسترسی مستقیم به سختافزارهای انویدیا ندارند، آشنایی با ابزارهای پروفایلینگ روی Trainium میتواند مسیرهای جایگزین برای آموزش مدلهای هوش مصنوعی را باز کند. هرچند دسترسی مستقیم به AWS Trainium نیز با چالشهای تحریم مواجه است، اما این دانش میتواند برای تیمهایی که از طریق واسطهها یا زیرساختهای ابری خارجی کار میکنند، ارزشمند باشد.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی