اعتماد به داوری مدلهای زبانی در سنجش نوآوری ایده
گزارشی در وبلاگ هاگینگفیس، آزمونی با نام NoveltyBench را معرفی میکند که توان مدلهای زبانی بزرگ را در داوری نوآوری ایدههای پژوهشی میسنجد. این نوشته بر ضرورت نظارت انسانی و سنجش دقیقتر اعتبار داوری خودکار تأکید دارد.
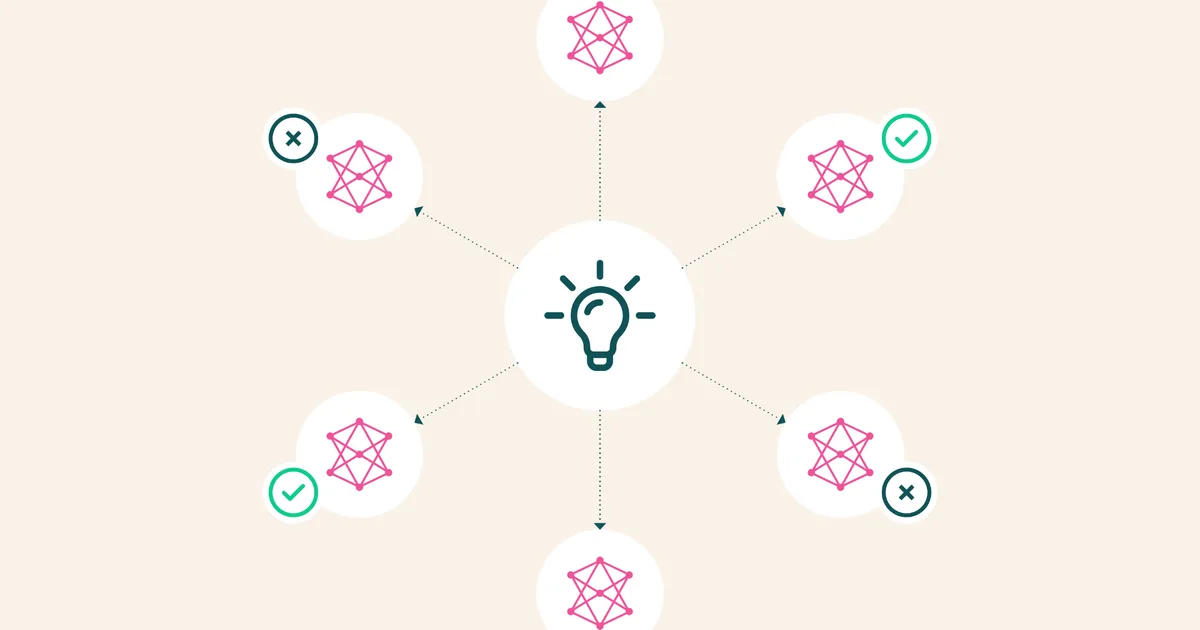
کاربرد مدلهای زبانی بزرگ (Large Language Models) بهعنوان داور خودکار در ارزیابی ایدههای پژوهشی و بازبینی همتا (Peer Review) در دو سال گذشته گسترش یافته است. پرسش اصلی این است که آیا این مدلها میتوانند قضاوتی قابل اتکا درباره نوآوری یک ایده داشته باشند یا خیر. نوشته تازه وبلاگ هاگینگفیس، با عنوان «آیا میتوان به مدلهای زبانی برای داوری نوآوری یک ایده پژوهشی اعتماد کرد؟»، به همین پرسش میپردازد. این گزارش آزمونی با نام NoveltyBench را معرفی میکند که از سوی پژوهشگران Allen Institute for AI (AI2) ارائه شده است. هدف این آزمون سنجش توان مدلها در تشخیص میزان تازگی و تمایز یک ایده پژوهشی نسبت به کارهای پیشین است؛ حوزهای که تا پیش از این عمدتاً بر قضاوت انسانی متکی بود. چنین ارزیابیهایی معمولاً با مقایسه داوری مدل و داوری متخصصان انسانی انجام میشود. محور بحث، محدودیتهای شناختهشده داوری خودکار است: حساسیت پاسخها به نحوه بیان پرسش، گرایش مدلها به تأیید و امتیازدهی خوشبینانه، و دشواری سنجش نوآوری واقعی در برابر نوآوری ظاهری. بر این اساس، نتیجهگیری گزارش آن است که سپردن کامل داوری نوآوری به مدلهای زبانی، بدون نظارت انسانی، قابل اتکا نیست و این ابزارها در بهترین حالت نقش دستیار را دارند. برای توسعهدهندگان ایرانی که در ساخت سامانههای ارزیابی پژوهش، ابزارهای بازبینی همتا یا خط تولید ایده به کمک مدلهای زبانی کار میکنند، این گزارش پیام عملی دارد: اتکای کامل به امتیاز مدل در سنجش نوآوری میتواند به نتیجهای گمراهکننده بینجامد. طراحی سامانههایی که خروجی مدل را در کنار داوری انسانی و معیارهای صریح قرار میدهند، هماکنون انتخاب مطمئنتری است. این نوشته در ادامه به جزئیات روششناسی آزمون و شیوه گردآوری دادههای آن میپردازد و آن را در دسترس پژوهشگران و توسعهدهندگان قرار میدهد.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی