استنتاج تا ۳.۲ برابر سریعتر با LFM2.5-DSpark
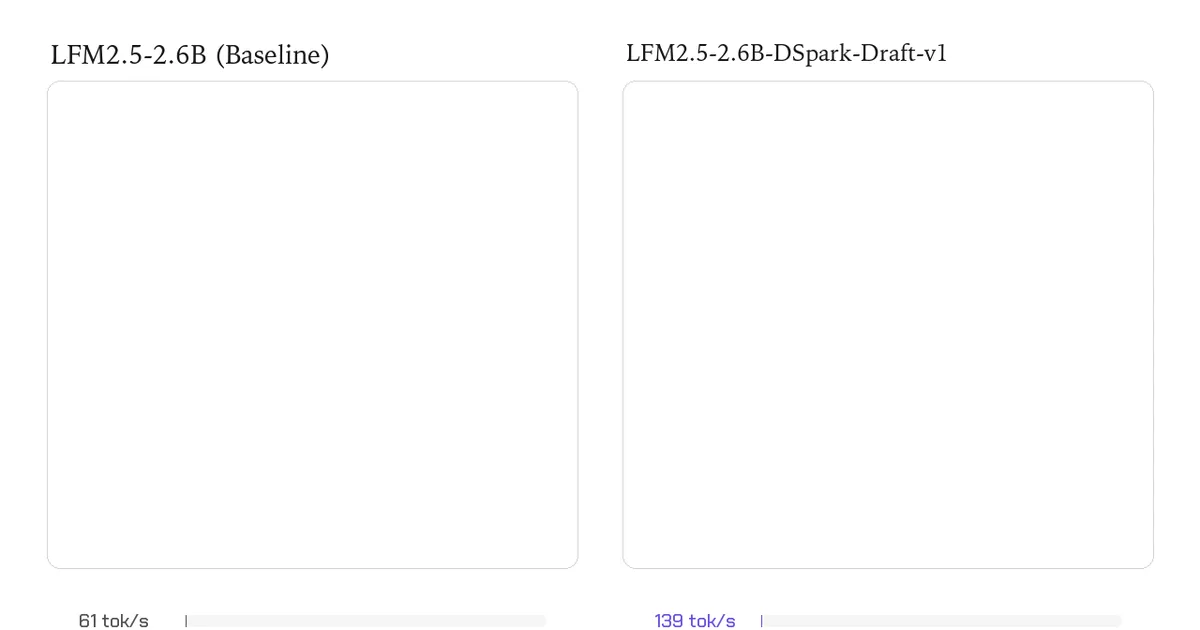
Liquid AI مدل LFM2.5-DSpark را با هدف افزایش تا ۳.۲ برابری سرعت استنتاج معرفی کرد. این مدل با بهینهسازیهای الگوریتمی، اجرای کارآمدتر روی سختافزارهای محدود را ممکن میسازد.
شرکت Liquid AI از مدل زبانی جدید خود با نام LFM2.5-DSpark رونمایی کرد. به گزارش وبلاگ Hugging Face، این مدل موفق شده است سرعت استنتاج (Inference) را در مقایسه با نسخههای پیشین تا ۳.۲ برابر افزایش دهد. این بهبود عمدتاً از طریق بهینهسازیهای الگوریتمی و اصلاح معماری مدل حاصل شده است. بر اساس اطلاعات منتشرشده، LFM2.5-DSpark با تمرکز بر کارایی محاسباتی طراحی شده و امکان اجرای مدل را روی سختافزارهای با منابع محدودتر فراهم میکند. این ویژگی میتواند برای استقرار مدلهای زبانی در محیطهای تولیدی و برنامههای کاربردی با تأخیر پایین حائز اهمیت باشد. جزئیات فنی کامل، از جمله بنچمارکهای سرعت و پیکربندیهای سختافزاری پشتیبانیشده، در پست وبلاگ Hugging Face در دسترس است. Liquid AI پیشتر نیز بر توسعه مدلهای سبک و کارآمد متمرکز بوده است. برای توسعهدهندگان ایرانی، این مدل میتواند گزینهای مناسب برای اجرای محلی مدلهای زبانی روی سرورهای محدود یا دستگاههای لبه (Edge) باشد. کاهش نیاز به منابع پردازشی، هزینه استقرار را پایین میآورد و امکان استفاده از مدلهای پیشرفتهتر را در زیرساختهای محلی فراهم میکند.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی