استنتاج مدل ۱۸۰ میلیارد پارامتری با ۳۲ گیگابایت رم
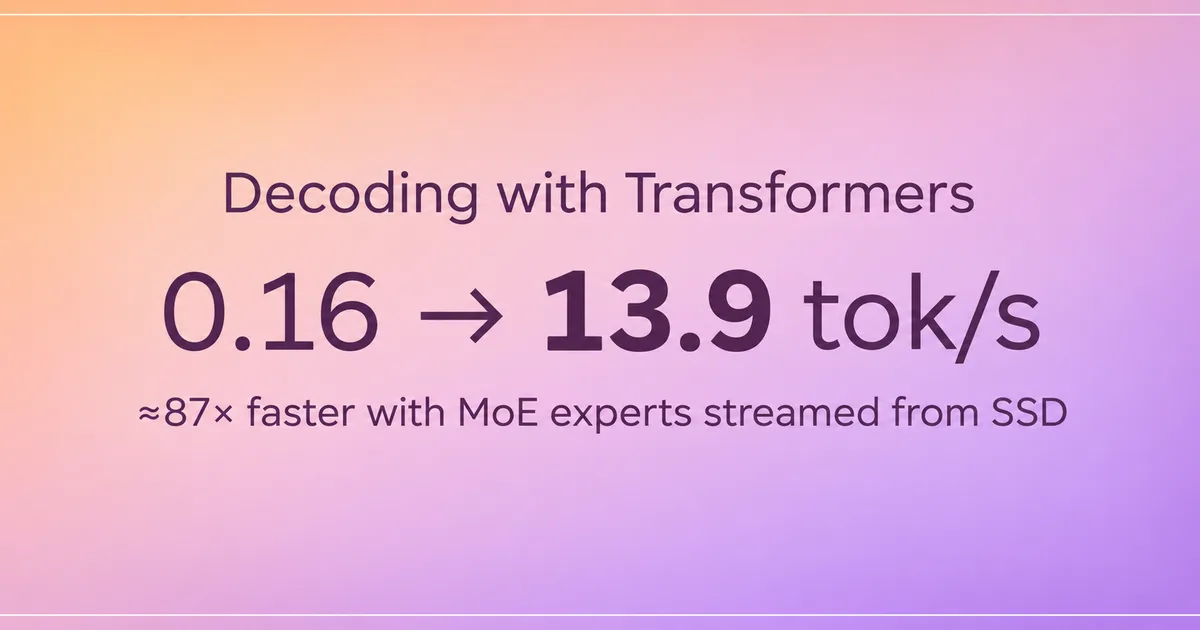
وبلاگ Hugging Face روشی مبتنی بر جریانسازی کارشناسان (expert streaming) در کتابخانه Transformers را معرفی کرده که اجرای استنتاج یک مدل ترکیب کارشناسان با ۱۸۰ میلیارد پارامتر را روی ۳۲ گیگابایت حافظه ممکن میکند. در این روش وزنهای غیرفعال روی حافظه ذخیرهسازی میمانند و تنها کارشناسان موردنیاز در هر مرحله بارگذاری میشوند.
وبلاگ رسمی Hugging Face در تاریخ ۱۸ نوامبر ۲۰۲۶ مطلبی منتشر کرد که در آن امکان اجرای استنتاج (inference) یک مدل ترکیب کارشناسان (Mixture of Experts یا MoE) با ۱۸۰ میلیارد پارامتر روی سختافزاری با تنها ۳۲ گیگابایت حافظه دسترسی تصادفی (RAM) بررسی شده است. محور این گزارش، استفاده از سازوکاری با عنوان جریانسازی کارشناسان (expert streaming) در کتابخانه Transformers است. در معماری ترکیب کارشناسان، مدل از چندین زیرشبکه تخصصی تشکیل میشود و در هر مرحله پردازش تنها بخش کوچکی از آنها فعال میشوند. روش جریانسازی کارشناسان از همین ویژگی بهره میبرد: بهجای آنکه تمام وزنهای مدل همزمان در حافظه بارگذاری شوند، تنها کارشناسان موردنیاز برای پردازش هر نشانه (token) از حافظه ذخیرهسازی خوانده و به حافظه اصلی منتقل میشوند. این کار سقف حافظه موردنیاز را از حجم کل مدل به حجم کارشناسان فعال در هر لحظه کاهش میدهد. بر اساس این گزارش، پیادهسازی مذکور در Transformers انجام شده و بر تعامل میان پهنای باند حافظه ذخیرهسازی، زمان بارگذاری کارشناسان و تأخیر (latency) استنتاج تمرکز دارد. محدودیت اصلی چنین رویکردی، سرعت پایینتر خواندن وزنها از دیسک در مقایسه با حافظه اصلی است؛ از این رو کارایی نهایی به شدت به نوع حافظه ذخیرهسازی و الگوی دسترسی مدل وابسته خواهد بود. برای توسعهدهندگان ایرانی، این روش اهمیت عملی دارد؛ زیرا بسیاری از تیمها به دلیل محدودیت دسترسی به پردازندههای گرافیکی (GPU) با حافظه بالا و هزینه بالای اجاره سرور، امکان اجرای مدلهای بزرگ را ندارند. رویکرد جریانسازی کارشناسان میتواند مسیر آزمون و ارزیابی مدلهای MoE را روی سرورهای ابری ارزانتر یا ایستگاههای کاری با حافظه محدود هموار کند، هرچند این راهکار جایگزین استنتاج با تأخیر پایین روی پردازنده گرافیکی نیست و باید با توجه به نیاز عملیاتی ارزیابی شود.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی