هاگینگ فیس محیطهای یادگیری تقویتی را به هاب آورد
هاگینگ فیس فیلتر و سازوکار برچسبگذاری جدیدی را برای محیطهای یادگیری تقویتی در هاب خود معرفی کرده است. این قابلیت از چهار چارچوب Harbor، Verifiers، OpenEnv و NeMo Gym پشتیبانی میکند و امکان کشف و استفاده مجدد از مجموعهوظایف را سادهتر میسازد.
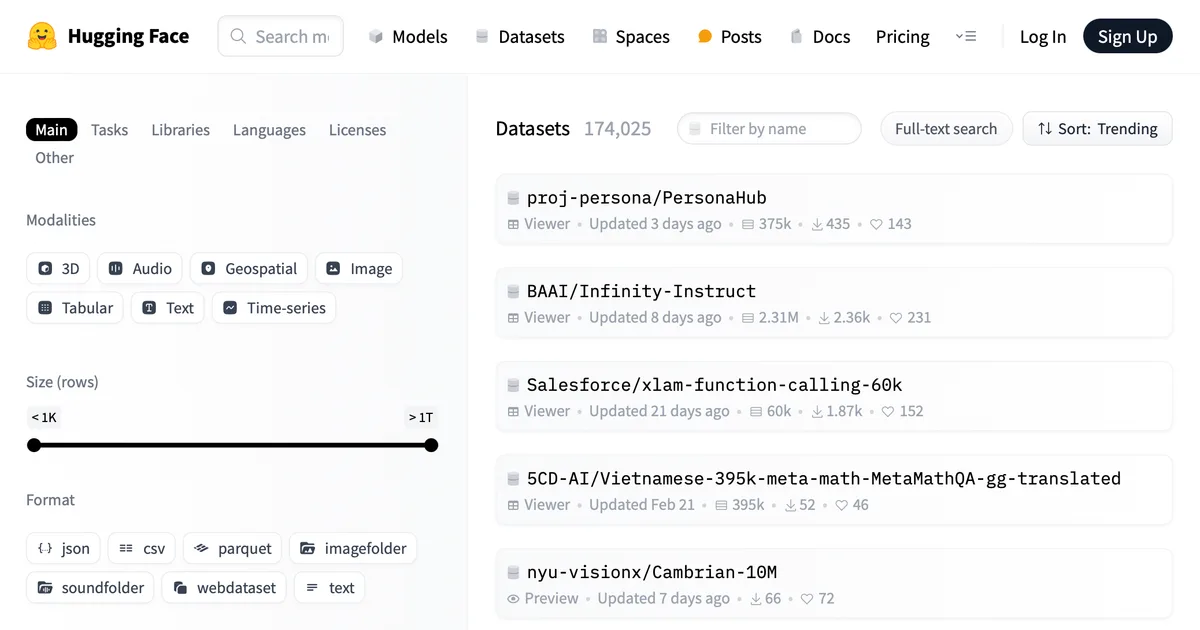
هاگینگ فیس در ۲۸ سپتامبر ۲۰۲۶ اعلام کرد که محیطهای یادگیری تقویتی (Reinforcement Learning Environments) اکنون جایگاه مشخصی در هاب این پلتفرم دارند. در این مدل، محیط یک وظیفه را در اختیار عامل قرار میدهد، به اقدامات آن پاسخ میدهد و نتیجه را امتیازدهی میکند؛ پاداش حاصل میتواند برای ارزیابی عملکرد یا بهعنوان سیگنال آموزشی در فرایند یادگیری استفاده شود. این انتشار در مرحله نخست بر مجموعهوظایف (Tasksets) تمرکز دارد. turn0view0 محیطهای یادگیری تقویتی در قالب مخزن مجموعهداده در هاب قرار میگیرند و با برچسب rl-environment در فیلتر جدید قابل مشاهده هستند. چهار چارچوب Harbor، Verifiers، OpenEnv و NeMo Gym نیز بهعنوان کتابخانههای محیط ثبت شدهاند. هر محیط میتواند همزمان با چند چارچوب سازگار باشد و برچسبهای مربوط به آن چارچوبها، دستور اجرای مناسب را در بخش استفاده از مجموعهداده نمایش میدهند. هاگینگ فیس تأکید کرده است که این سازوکار به ایجاد نوع جدیدی از مخزن یا سامانه ثبت محیطها نیاز ندارد. turn0view0 برای توسعهدهندگان ایرانی، این تغییر میتواند دسترسی و مقایسه مجموعهوظایف استاندارد برای ارزیابی عاملهای هوش مصنوعی را سادهتر کند. محیطهایی که از چارچوبهای پشتیبانیشده استفاده میکنند را میتوان از یک هاب واحد کشف کرد و در صورت وجود زیرساخت لازم، بهصورت محلی یا روی زیرساخت ابری اجرا کرد؛ بنابراین توسعه و آزمون عاملهای کدنویسی، استفاده از ابزار و سایر کاربردهای مبتنی بر یادگیری تقویتی میتواند بر مجموعهدادههای نسخهبندیشده و قابل بازاستفاده متکی باشد. citeturn0view0
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی