هاگینگفیس: ارزیابهای تعبیهشده هوش مصنوعی راهحل سادهای نیستند
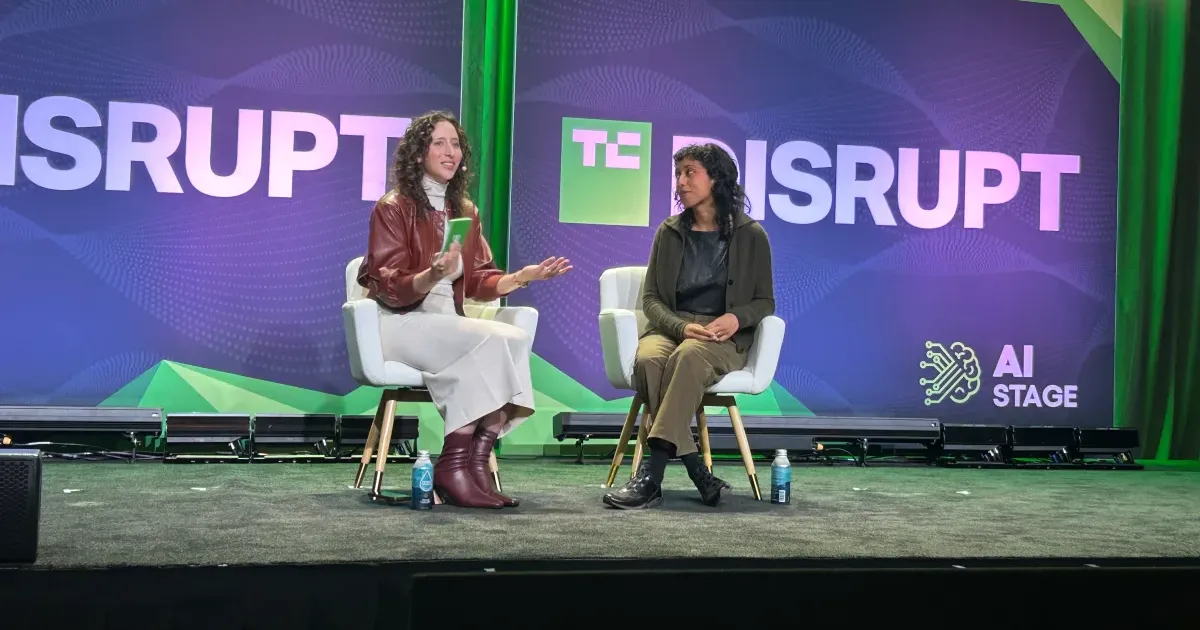
ایرن سلیمان، مدیر سیاستگذاری هاگینگفیس، در نشست تککرانچ اعلام کرد که روشهای ارزیابی مدلهای هوش مصنوعی پیچیده و هنوز در حال تکامل هستند. وی تأکید کرد که ارزیابهای تعبیهشده راهحل سادهای برای چالشهای ارزیابی نخواهند بود.
ایرن سلیمان، مدیر سیاستگذاری (Chief Policy Officer) هاگینگفیس، در گفتوگویی در نشست تککرانچ اعلام کرد که روشهای ارزیابی مدلهای هوش مصنوعی پیچیدهتر از آن است که بهعنوان راهحلی ساده برای سنجش کیفیت مدلها در نظر گرفته شوند. وی اشاره کرد که سیستمهای ارزیابی که قرار است بهصورت بیطرفانه برتری یک محصول هوش مصنوعی را بر دیگری سنجش کنند، همچنان در مرحله بلوغ قرار دارند. آزمایشگاههای هوش مصنوعی اعتبار حرفهای خود را بر پایه معیارهای سنجش مدل (Model Benchmarking) قرار دادهاند — سیستمی که ظاهراً بیطرف و دقیق طراحی شده تا کیفیت محصولات هوش مصنوعی را بسنجد. با این حال، سلیمان تأکید کرد که روشهای پشت این ارزیابیها پیچیده است و هنوز در حال توسعه و تکامل میباشد. مسئله ارزیابهای تعبیهشده (Embedded AI Evaluators) — یعنی سیستمهایی که درون خود مدلها برای ارزیابی خودکار تعبیه میشوند — بهعنوان راهحلی بالقوه برای چالشهای ارزیابی مطرح شدهاند. اما سلیمان هشدار داد که این رویکرد نیز چالشهای خاص خود را دارد و نباید بهعنوان راهحلی آسان در نظر گرفته شود. برای توسعهدهندگان ایرانی که با پلتفرمهای هوش مصنوعی کار میکنند، این موضوع اهمیت ویژهای دارد. انتخاب مدلهای هوش مصنوعی صرفاً بر اساس امتیازهای معیارهای ارزیابی میتواند گمراهکننده باشد و توسعهدهندگان باید با آزمایشهای مستقل و متناسب با کاربردهای خاص خود، کیفیت مدلها را بسنجند. این موضوع بهویژه در پروژههایی که از طریق API با مدلهای مختلف ادغام میشوند، حائز اهمیت است. نظرات سلیمان نشاندهنده نگرانیهای گستردهتر در صنعت هوش مصنوعی درباره شفافیت و قابلیت اطمینان روشهای ارزیابی است. با افزایش رقابت میان آزمایشگاههای هوش مصنوعی، نیاز به استانداردهای ارزیابی مستقل و قابل اعتماد بیش از پیش احساس میشود.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی