انتشار Dharma Field Extractor برای استخراج داده اسناد
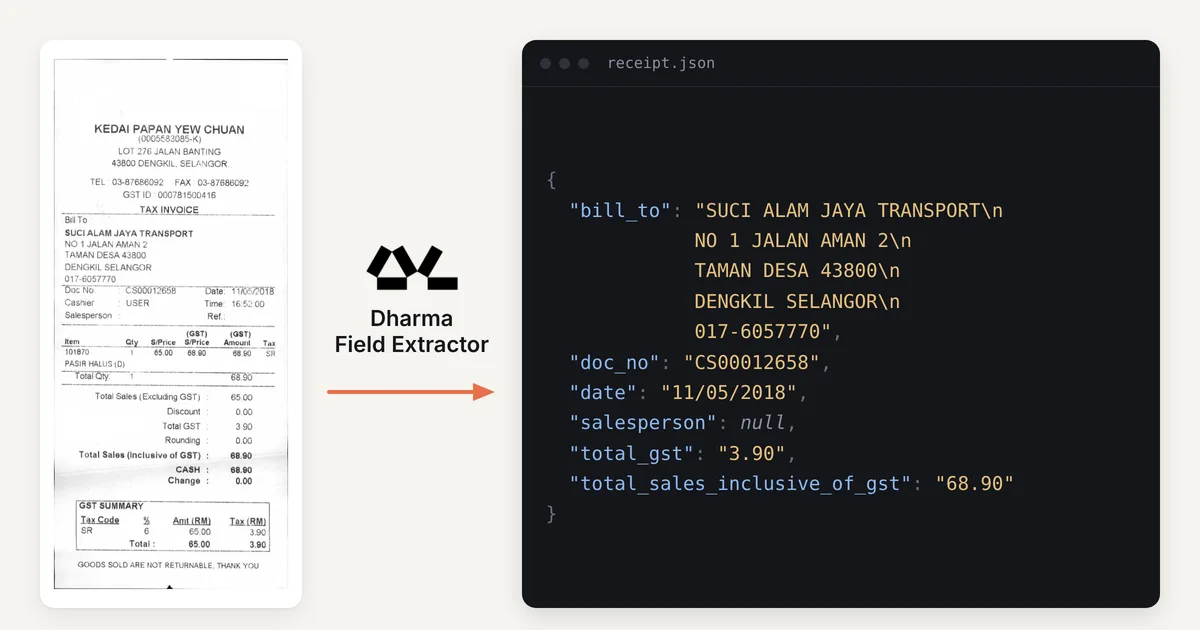
تیم Dharma-AI در وبلاگ Hugging Face از ابزار Dharma Field Extractor رونمایی کرد که هر نوع سند را دریافت و فیلدهای ساختاریافته را در قالب JSON بازمیگرداند. این ابزار برای خودکارسازی استخراج داده از اسناد بدون ساختار و اتصال آن به پایگاه داده و خطوط پردازش معرفی شده است.
تیم Dharma-AI در تاریخ چهارم نوامبر ۲۰۲۶ در وبلاگ Hugging Face از ابزار Dharma Field Extractor رونمایی کرد. بر پایه عنوان منتشرشده، این ابزار هر نوع سند را به عنوان ورودی میپذیرد و فیلدهای ساختاریافته را در قالب JSON (JavaScript Object Notation) بازمیگرداند. کاربرد اعلامشده این ابزار، تبدیل محتوای بدون ساختار (unstructured content) به داده ماشینخوان (machine-readable data) است؛ فرایندی که معمولاً شامل اسناد اداری، فرمها و قراردادها میشود و در خطوط پردازش (pipeline) و پایگاه داده کاربرد دارد. خروجی JSON امکان اتصال مستقیم این دادهها به سامانههای نرمافزاری را فراهم میکند. جزئیات فنی این انتشار، از جمله معماری مدل، حجم پارامترها، معیارهای ارزیابی، مجوز استفاده و شیوه دسترسی به وزنهای مدل، در متن ارائهشده به این خبرگزاری در دسترس نبود و ارزیابی دقیق کارکرد آن نیازمند مراجعه به مستندات رسمی پروژه است. برای توسعهدهندگان ایرانی، ابزارهای استخراج فیلد از اسناد میتوانند در خودکارسازی سامانههای اداری، مالی و بایگانی کاربرد داشته باشند، بهویژه در مواردی که حجم بالای اسناد کاغذی یا تصویری نیاز به ورود دستی اطلاعات را افزایش میدهد. در صورت پشتیبانی از اجرای محلی (on-premise) و ارائه وزنهای مدل، امکان استفاده در محیطهای بدون دسترسی پایدار به سرویسهای ابری نیز فراهم میشود؛ موضوعی که برای پروژههای داخلی اهمیت عملی دارد. ارزیابی دقت این ابزار در پردازش متون فارسی و اسناد راستبهچپ، مستلزم آزمون مستقل است و در مطلب منتشرشده به آن اشارهای نشده است.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی