بنچمارکهای مدل زبانی دقیقاً چه چیزی را میسنجند؟
آزمایشگاه Ai2 چارچوب BenchMIRT را برای تحلیل دقیقتر بنچمارکهای مدل زبانی معرفی کرد. این روش با استفاده از نظریه پاسخ سؤال نشان میدهد نمرات خام بنچمارکها تا حدی تحت تأثیر قالب سؤال و نه فقط توانایی واقعی مدل هستند.
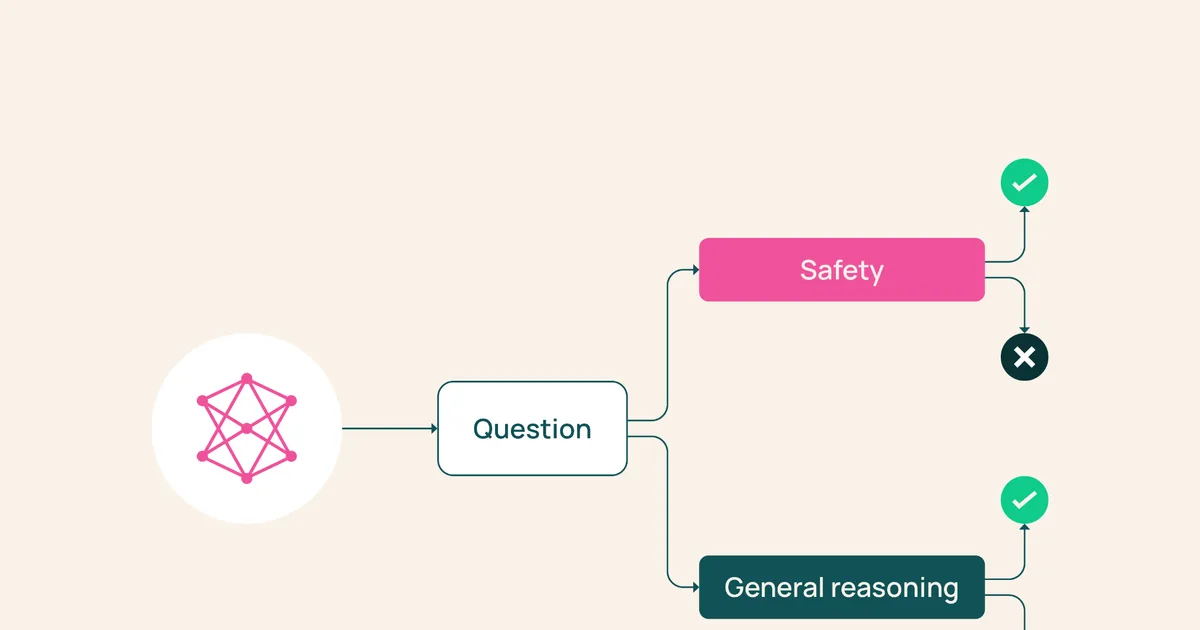
آزمایشگاه هوش مصنوعی آلن (Allen Institute for AI) در وبلاگ خود چارچوبی تحلیلی به نام BenchMIRT را معرفی کرد که هدف آن پاسخ به این پرسش است که بنچمارکهای مدل زبانی (LLM) واقعاً چه چیزی را اندازهگیری میکنند. این چارچوب بر پایه مدلهای نظریه پاسخ سؤال (Item Response Theory) بنا شده است، خانوادهای از مدلهای آماری که در آزمونسازی آموزشی برای تفکیک دشواری سؤال از توانایی پاسخدهنده به کار میرود. بر اساس این تحلیل، نمرات خام بنچمارکها میتوانند تصویری ناقص یا گمراهکننده از توانایی مدل ارائه دهند. BenchMIRT با مدلسازی همزمان دشواری سؤال، توانایی مدل و حساسیت به قالب پرسش، نشان میدهد بخشی از تفاوت عملکرد مدلها ناشی از آشنایی آنها با شکل و ساختار سؤال است، نه الزاماً توانایی استدلال یا دانش واقعی آنها. نتایج تحلیل دادههای چند بنچمارک رایج نشان میدهد که برخی مدلها در برابر تغییرات جزئی در صورتبندی سؤال عملکرد ناپایدارتری دارند. این یافته پیامدهایی برای مقایسه مدلها و انتخاب آنها بر اساس نمرات بنچمارک دارد و بر ضرورت گزارش شفاف روش ارزیابی تأکید میکند. برای توسعهدهندگان ایرانی که برای انتخاب مدل مناسب پروژههای خود به نمرات بنچمارک اتکا میکنند، این پژوهش یادآور مهمی است: نمره بالاتر در یک بنچمارک لزوماً به معنای عملکرد بهتر در کاربرد واقعی نیست. توصیه میشود ارزیابی مدلها با مجموعه دادههای داخلی و متناسب با زبان فارسی و نیازهای مشخص پروژه انجام شود. BenchMIRT یک ابزار ارزیابی جدید نیست، بلکه چارچوبی برای تفسیر بهتر نتایج ارزیابیهای موجود است. جزئیات روششناسی و یافتههای کامل در وبلاگ Hugging Face منتشر شده است.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی