AutoSynthData برای آموزش عاملهای سازمانی معرفی شد
سرویسناو چارچوب AutoSynthData را برای تولید و اعتبارسنجی دادههای آموزشی مصنوعی برای عاملهای سازمانی معرفی کرد. آزمایشهای EnterpriseOps Gym نشان دادند که آموزش با این دادهها میانگین Pass@1 را در محیطهای Hybrid و ITSM افزایش داده است.
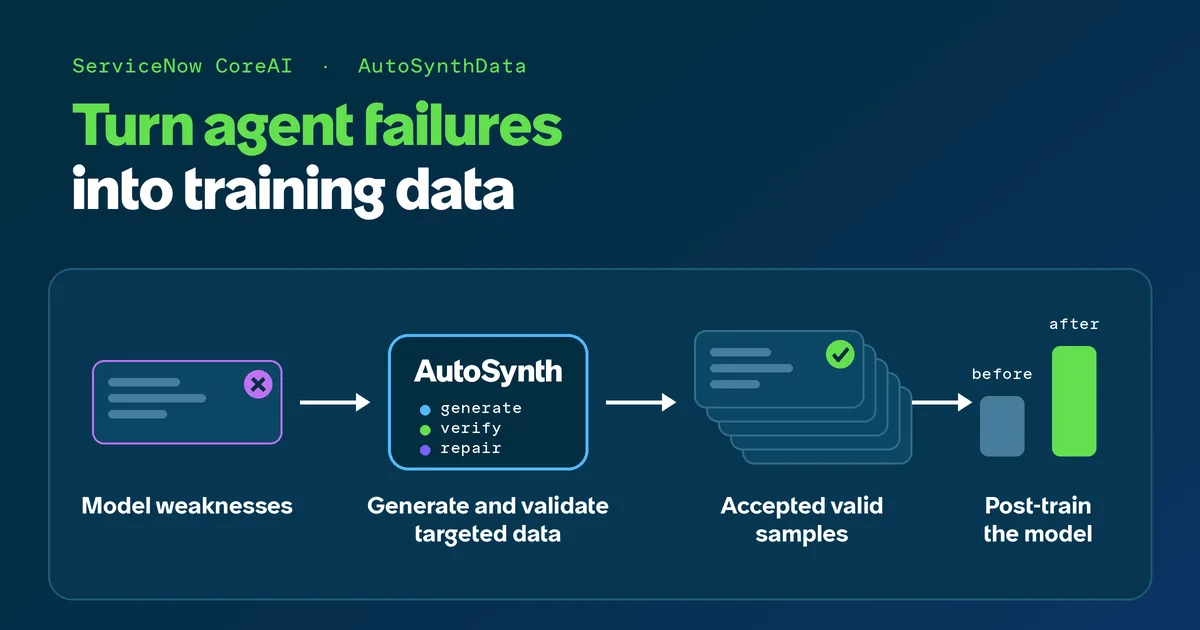
سرویسناو (ServiceNow) چارچوب AutoSynthData را برای تولید داده آموزشی مصنوعی ویژه عاملهای هوش مصنوعی سازمانی معرفی کرده است. این چارچوب ابتدا خطاهای یک مدل هدف را در یک محیط سازمانی شناسایی میکند و سپس با کمک یک مدل معلم قویتر، شکافهای توانمندی را به وظایف آموزشی جدید تبدیل میکند. هر وظیفه شامل مشخصات سامانه، درخواست کاربر و یک اعتبارسنج (Verifier) است. AutoSynthData وظایف تولیدشده را پیش از ورود به مجموعه آموزشی در محیط هدف اجرا میکند. فرآیند اعتبارسنجی شامل بررسی مثبت برای اطمینان از موفقیت مسیر مرجع و بررسی منفی برای اطمینان از رد نتایج نادرست است. نمونههای ناموفق نیز وارد چرخه نقد و تعمیر محدود میشوند و بررسی سطح مجموعه برای کنترل تنوع، پوشش توانمندیها و جلوگیری از تکرار انجام میشود. در آزمایش حوزه Hybrid از EnterpriseOps Gym، این چارچوب با مدل Gemma-4-26B-A4B-it بهعنوان مدل هدف و Qwen3.8-27B بهعنوان مدل معلم استفاده شد. AutoSynthData حدود ۲ هزار نمونه آموزشی را در ۱۸ ساعت تولید کرد و آموزش نظارتشده (Supervised Fine-Tuning یا SFT) میانگین Pass@1 را ۷.۲ واحد درصد افزایش داد؛ موفقیت اعتبارسنج نیز از ۶۳.۰۱ درصد به ۶۸.۵۵ درصد رسید. در حوزه ITSM نیز ۱٬۹۹۴ نمونه در ۶۶ ساعت تولید شد و میانگین Pass@1 از ۱۸.۷۷ به ۲۷.۱۸ درصد افزایش یافت. برای توسعهدهندگان ایرانی، رویکرد AutoSynthData نشان میدهد که تولید انبوه داده مصنوعی برای عاملهای سازمانی زمانی ارزشمندتر است که به محیط اجرایی، ابزارها و وضعیت دادهها متصل باشد و هر نمونه با اعتبارسنج قابل آزمون همراه شود. این الگو میتواند برای ساخت داده آموزشی در محیطهای سازمانی بومی نیز قابل استفاده باشد، مشروط بر اینکه وظایف، سیاستهای دسترسی، وضعیت سامانهها و معیارهای موفقیت بهصورت قابل اجرا و دقیق تعریف شوند.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی