اجرای Async GRPO با LoRA روی Hugging Face Jobs
هگینگ فیس معماری اجرای AsyncGRPO با آداپتر LoRA را روی Hugging Face Jobs تشریح کرده است که بدون NCCL و با استفاده از Storage Bucket مشترک میان ماشینها کار میکند. در آزمایش نهایی، بهینهسازی گلوگاههای آموزش و تولید زمان اجرای ۵۰۰ مرحله را از ۳ ساعت و ۲۷ دقیقه به حدود ۵۳ دقیقه کاهش داد.
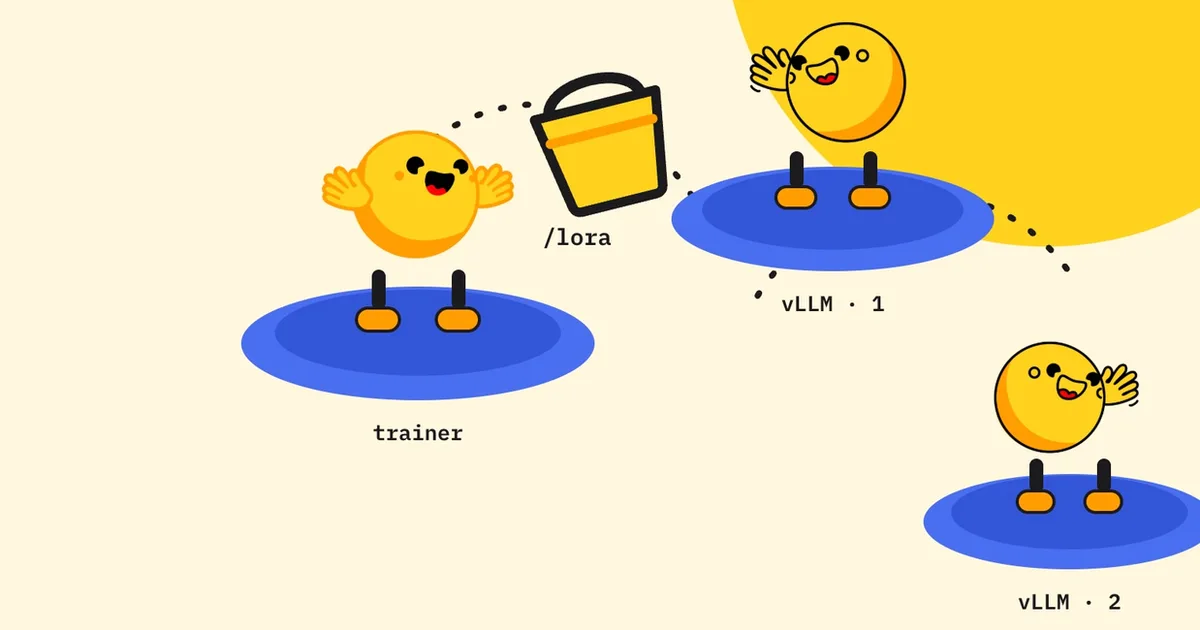
هگینگ فیس معماری جدیدی برای اجرای آموزش تقویتی غیرهمزمان (Async GRPO) با آداپتر LoRA روی Hugging Face Jobs تشریح کرده است. در این معماری، آموزش و استنتاج روی ماشینهای جداگانه اجرا میشوند و بهجای انتقال کامل وزنهای مدل، تنها آداپتر چندمگابایتی LoRA میان آنها همگام میشود. این قابلیت با AsyncGRPOTrainer در نسخه 1.14 کتابخانه TRL ارائه شده است. در این طراحی، یک Job برای آموزش، دو Job برای سرویسدهی vLLM و یک Storage Bucket مشترک استفاده میشوند. آداپتر آموزشدیده در Bucket ذخیره میشود و هر نمونه vLLM آن را از همان مسیر بارگذاری میکند؛ بنابراین ارتباط مستقیم شبکهای یا NCCL میان Jobها لازم نیست. یک پروکسی نیز درخواستهای تولید را میان نمونهها توزیع میکند و بارگذاری آداپتر را بهصورت هماهنگ در همه نمونهها انجام میدهد. پروکسی برای افزایش استفاده از کش کلید-مقدار (KV cache) درخواستهای مربوط به یک ورودی را تا حد امکان به نمونهای هدایت میکند که پیشوند همان ورودی را قبلاً پردازش کرده است. در آزمایش ۶۴٬۷۲۸ درخواست تولید، ۸۴٫۵ درصد درخواستها از این وابستگی به کش بهره بردند، در حالی که ۱۴٫۲ درصد درخواستها بدون تطبیق کش و ۱٫۳ درصد با تغییر مسیر ناشی از بارگذاری انجام شدند. همچنین شاخص نسبت (ratio) در تمام ۱۲۶ همگامسازی در محدوده نزدیک به ۱ باقی ماند که نشان میداد نسخه سیاست مورد استفاده برای تولید با نسخه مورد استفاده در آموزش مطابقت داشته است. در آزمایش اولیه، ۵۰۰ مرحله آموزش ۳ ساعت و ۲۷ دقیقه زمان برد و مشخص شد گلوگاه اصلی آموزش است، نه تولید. با تغییر شکل دستهها، غیرفعالکردن محاسبه مجدد گرادیان (gradient checkpointing)، افزایش بودجه توکن و تنظیم صف تولید، زمان اجرای همین فرایند در آزمایش نهایی به حدود ۵۳ دقیقه کاهش یافت. هزینه اجرای پیکربندی سهJob شامل یک Job آموزشی با دو H200 و دو Job استنتاجی تکGPU حدود ۲۰ دلار در ساعت گزارش شده است. برای توسعهدهندگان ایرانی، این معماری نمونهای عملی از اجرای آموزش تقویتی توزیعشده بدون وابستگی به ارتباط مستقیم میان چند گره ارائه میکند. استفاده از LoRA و ذخیرهسازی مشترک میتواند نیاز به انتقال مکرر چند گیگابایت وزن مدل را کاهش دهد و برای محیطهایی که دسترسی به زیرساختهای ارتباطی مبتنی بر NCCL محدود است، گزینهای قابل بررسی باشد.
این مدل در اپکس۲۴ قابل دسترس است
یک کلید API — ۵۰+ مدل هوش مصنوعی